Stellen Sie sich vor, die Betriebsratssitzung ist vorbei. Eineinhalb Stunden Gespräch, aufgezeichnet, weil niemand mitschreiben wollte.
Jetzt soll daraus ein Protokoll werden. Mit Zeitmarken, damit man Stellen wiederfindet. Und mit der Angabe, wer was gesagt hat.
Der schnellste Weg ist ein Cloud-Dienst. Datei hochladen, Text zurück. Er hat nur einen Haken: Die Aufnahme muss dafür das Haus verlassen.
Ich wollte wissen, ob es auch anders geht: lokale Transkription auf eigener Hardware. Die Antwort ist ja, und das in etwa der halben Aufnahmedauer.
Aufnahmen entstehen nebenbei, Protokolle nicht
In vielen Häusern wird inzwischen aufgezeichnet. Besprechungen über Videokonferenz, Diktate unterwegs, das Telefon, das bei einem Gespräch auf dem Tisch liegt.
Abgetippt wird davon wenig. Zu aufwendig, zu lang, und am Ende liegt die Datei in einem Ordner, den niemand mehr öffnet.
Automatische Transkription ändert das. Sie macht aus einer Aufnahme Text, in einem Bruchteil der Zeit, die ein Mensch zum Abtippen braucht.
Die meisten Angebote dafür laufen in der Cloud. Das ist bequem und für viele Aufnahmen auch völlig in Ordnung.
Für manche nicht. Ein Bewerbungsgespräch, eine Verhandlung mit einem Lieferanten, eine Sitzung des Betriebsrats. Bei solchen Aufnahmen stellt sich vor jeder Bequemlichkeit eine andere Frage: Wer bekommt sie zu sehen?
Wer diese Frage beantworten kann, entscheidet selbst, welche Aufnahme wohin geht. Wer sie nicht beantworten kann, erfährt es im Zweifel erst, wenn jemand nachfragt.
Was ich gebaut habe: lokale Transkription in zwei Schritten
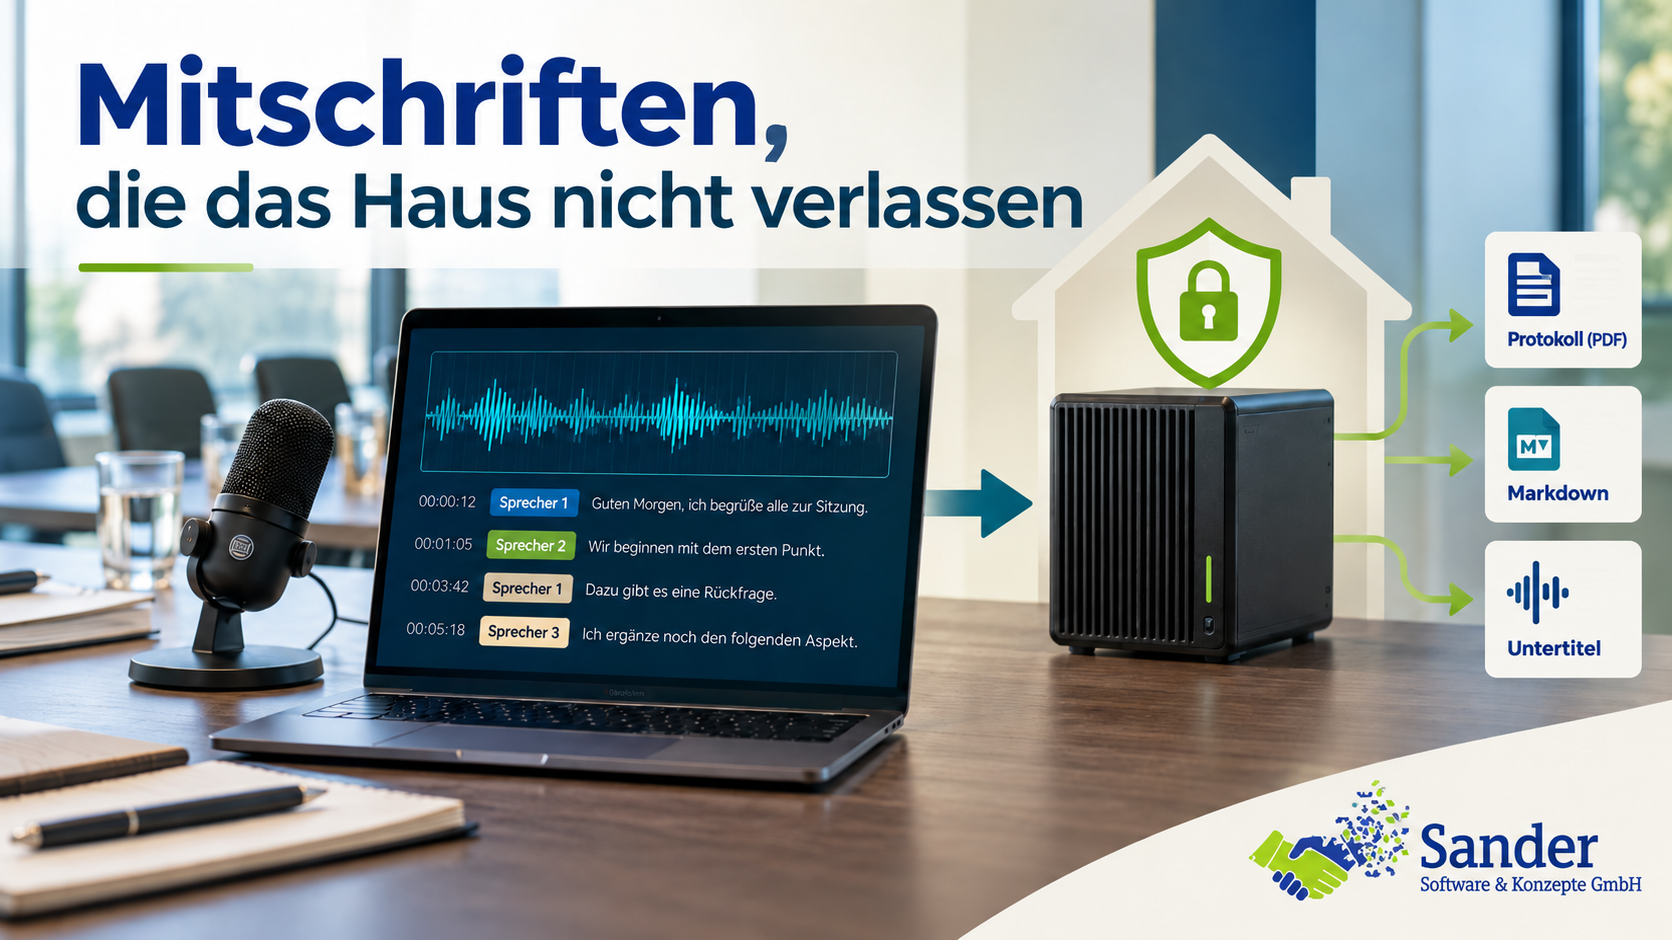
Die Strecke läuft vollständig auf eigener Hardware. Im Betrieb ohne Internetzugriff, ohne Cloud-Dienst und ohne Konto bei einem Anbieter. Die Datei geht nur von der Workstation zum Server im eigenen Netz und zurück.
Die Bedienung ist ein einziger Aufruf von der Workstation: Datei rein, Ergebnisse zurück. Die hochgeladene Kopie und alle Zwischendateien werden nach dem Abholen standardmäßig auf dem Server gelöscht.
Zwei frei verfügbare, quelloffene Werkzeuge tragen die Arbeit.
| Schritt | Werkzeug | Was es tut |
|---|---|---|
| Spracherkennung | whisper.cpp mit dem Modell large-v3-turbo (1,6 GB) |
macht aus der Aufnahme Text mit Zeitmarken, erkennt die Sprache selbst |
| Sprechertrennung | sherpa-onnx mit einem Segmentierungs- und einem Stimmmodell | ordnet Abschnitte Personen zu, unsichere bleiben „unklar" |
| Aufbereitung | eigenes Skript | erzeugt die Lesefassung |
Am Ende liegen mehrere Dateien neben der Aufnahme. Eine Lesefassung zum Durchblättern, mit Zeitmarke und Sprecher je Absatz, für A4 eingerichtet und damit direkt als PDF druckbar. Dazu eine Markdown-Fassung für die maschinelle Weiterverarbeitung und Untertiteldateien.
Gerechnet wird ausschließlich auf dem Prozessor. Die Grafikeinheit des Rechners wird für diese Strecke nicht gebraucht.
Die Hardware ist ein NVIDIA DGX Spark mit 20 Prozessorkernen. Zehn davon sind leistungsstark, zehn sparsam. Das spielt weiter unten noch eine Rolle.
Was es braucht: die Messwerte
Die Zahlen unten stammen aus meiner eigenen Messreihe vom 9. September bis Anfang Oktober 2026. Jeder Lauf schreibt seine Kennzahlen automatisch in eine Tabelle, sodass die Reihe im Alltag mitwächst.
Zuerst die drei langen Aufnahmen, weil sie dem Alltag am nächsten kommen. Bei der dritten wurde die Dauer der Sprechertrennung nicht erfasst.
| Aufnahme | Spracherkennung | Sprechertrennung | zusammen |
|---|---|---|---|
| 30:32 Minuten | 11:37 Minuten | 2:50 Minuten | rund 15 Minuten |
| 32:12 Minuten | 15:12 Minuten | nicht erfasst | |
| 2:01:02 Stunden | 43:57 Minuten | 16:46 Minuten | 1:01:07 Stunden |
Als Faustregel daraus: Eine Stunde Aufnahme braucht etwa eine halbe Stunde, Sprechertrennung eingeschlossen, bei schwierigem Material eher mehr. Die Spracherkennung allein braucht je nach Aufnahme 36 bis 47 Prozent der Aufnahmedauer.
Länger heißt dabei nicht automatisch günstiger. Die Spracherkennung wurde bei der zweistündigen Aufnahme etwas schneller (Faktor 2,75 statt 2,63), die Sprechertrennung dagegen anteilig langsamer.
Einzelwerte sind angreifbar. Deshalb habe ich zwei kürzere Sprachnotizen von gut zwei und vier Minuten jeweils dreimal mit derselben Einstellung durchlaufen lassen.
Direkt hintereinander gemessen lagen die drei Läufe jeweils höchstens eine Sekunde auseinander. Über verschiedene Tage schwankte dieselbe Datei um bis zu 14 Prozent. Für die Planung reicht das, für eine Zusage auf die Minute nicht.
Der größte Hebel war keine Hardware
Am ersten Tag lief die Spracherkennung deutlich langsamer, als die Hardware hätte leisten müssen.
whisper.cpp nutzt ohne ausdrückliche Angabe vier Rechenstränge, so steht es in der Befehlsübersicht des Projekts. Auf einem Rechner mit 20 Kernen bleibt damit der größte Teil ungenutzt.
Auf den beiden Sprachnotizen brauchte die Spracherkennung mit vier Rechensträngen das 2,5- bis 2,7-Fache der Zeit, die sie mit allen 20 Kernen brauchte. Der Unterschied ist eine Zeile Konfiguration.
Beim Werkzeug für die Sprechertrennung war es dasselbe Muster, nur später entdeckt. sherpa-onnx rechnet ohne Angabe mit einem einzigen Rechenstrang je Modell. Aufgefallen ist mir das erst am 4. Oktober, knapp vier Wochen nach dem ersten Lauf. Die Zeiten der Sprechertrennung oben stammen aus diesen einfädigen Läufen. Wie viel mehr Rechenstränge dort bringen, ist noch nicht gemessen.
Was nach einer Grenze der Hardware aussieht, ist oft eine Voreinstellung. Wer nur auf die Laufzeit schaut, kauft im Zweifel den größeren Rechner, statt die Einstellung zu prüfen.
Wie viel Rechner braucht es wirklich?
Das ist die Frage, die für die meisten Häuser zählt. Kaum jemand hat einen DGX Spark im Serverraum.
Ich habe dieselbe Aufnahme deshalb mit 4, 8 und 20 Kernen laufen lassen. Bei 4 und 8 Kernen wählt die Strecke nur leistungsstarke Kerne, bei 20 kommen die zehn sparsamen dazu.
Die Werte gelten für die Sprachnotiz von gut zwei Minuten, je dreimal gemessen.
| Kerne | Laufzeit | Verhältnis zur Aufnahmedauer |
|---|---|---|
| 4 | 125 Sekunden | etwa Echtzeit (Faktor 1,09) |
| 8 | 64 Sekunden | gut doppelt so schnell (Faktor 2,14) |
| 20 | 46 Sekunden | knapp dreimal so schnell (Faktor 2,98) |
Die Reihe zeigt zwei Dinge. Von vier auf acht leistungsstarke Kerne halbiert sich die Laufzeit fast genau. Von acht auf zwanzig, also zwei weitere schnelle und zehn sparsame Kerne, steigt das Tempo nur noch um 30 bis 40 Prozent.
Und: Mit vier schnellen Kernen lief die Spracherkennung bei beiden Sprachnotizen etwa so schnell wie die Aufnahme selbst (Faktor 0,9 bis 1,1). Für eine Stunde Besprechung heißt das grob eine Stunde Spracherkennung, dazu die Sprechertrennung, die ich mit vier Kernen nicht gemessen habe. An langem Material steht diese Messung noch aus.
Für ein Protokoll, das am nächsten Morgen vorliegen soll, wäre auch das noch schnell genug.
Was ich nicht gemessen habe, ist ein gewöhnlicher Server mit Intel- oder AMD-Prozessor. Die Kerne im DGX Spark sind ARM-Kerne, eine andere Bauart. Die Reihe zeigt die Größenordnung, sie ersetzt keinen Test auf Ihrer eigenen Hardware.
Lieber „unklar" als geraten
Die Sprechertrennung, oft auch Sprechererkennung genannt, ordnet nicht jeden Abschnitt einer Person zu. Wenn ein Abschnitt nicht eindeutig genug ist, steht dort „unklar" statt einer geratenen Zuordnung.
Wie viel unklar bleibt, hängt am Material. Bei einem Zweiergespräch von einer halben Stunde mit vielen kurzen Wechseln waren es 32,4 Prozent der Abschnitte. Bei der zweistündigen Aufnahme mit langen Redeanteilen nur 1,4 Prozent.
Ich halte das für die richtige Richtung. Ein Protokoll, das eine Aussage der falschen Person zuschreibt, ist schlechter als eines, das offen sagt, wo es unsicher ist.
Wie treffsicher die zugeordneten Abschnitte sind, habe ich allerdings noch nicht gemessen. Dafür braucht es einen Vergleich gegen eine von Hand beschriftete Aufnahme. Das ist das Thema eines eigenen Beitrags.
Wo die Grenzen liegen
Ein Machbarkeitsnachweis ist kein Produkt. Diese Punkte sind offen, und ich nenne sie, bevor jemand danach fragt.
Wortfehlerrate. Wie viele Wörter die Spracherkennung bei deutschem Material falsch erkennt, ist nicht gemessen. Auch dafür braucht es eine von Hand abgetippte Vergleichsaufnahme.
Sprachwechsel. whisper.cpp erkennt die Sprache einmal am Anfang und behält sie. Ob ein Wechsel mitten in der Aufnahme sauber verarbeitet wird, ist ungeprüft.
Personenzahl. Die Sprechertrennung braucht die Zahl der Personen als Vorgabe. Ohne diese Angabe zerfiel die Zuordnung in meinem Versuch in 35 vermeintliche Sprecher, 30 davon mit weniger als einem Prozent Redeanteil.
Andere Hardware. Alle Werte stammen von einem Rechner. Für eine Aussage über Ihre Server braucht es einen Lauf auf Ihren Servern.
Der Prüfschritt für Montag
Sie brauchen dafür keinen Konsolenzugang. Sie brauchen eine Mail an Ihre IT mit drei Fragen.
Erstens: Wo liegen die Aufzeichnungen unserer Besprechungen, und wer hat Zugriff darauf?
Zweitens: Werden diese Aufzeichnungen abgetippt oder zusammengefasst, und wenn ja, von welchem Dienst?
Drittens: Gibt es Aufnahmen, die dieses Haus nicht verlassen dürfen, und ist das irgendwo festgehalten?
Wenn die dritte Frage mit „das haben wir nie unterschieden" beantwortet wird, haben Sie das Ergebnis. Nicht als Vorwurf, sondern als offene Festlegung.
Wenn Sie wissen wollen, welche Ihrer Aufnahmen das Haus nicht verlassen dürfen: schreiben Sie mir. Ich schaue mir das mit Ihnen an.
Fazit
Lokale Transkription ist kein Forschungsprojekt mehr. Mit zwei frei verfügbaren Werkzeugen wird aus einer Stunde Aufnahme in etwa einer halben Stunde ein Protokoll mit Zeitmarken und Sprechern, ohne dass eine Datei das eigene Netz verlässt.
Die wichtigste Erkenntnis war dabei nicht die Geschwindigkeit. Es war, wie viel davon in Voreinstellungen steckt.
| Frage | Ergebnis aus der Messreihe | Was offen ist |
|---|---|---|
| Wie schnell? | eine Stunde Aufnahme in etwa einer halben Stunde, Sprechertrennung eingeschlossen, schwieriges Material länger | Werte von einem Rechner mit 20 Kernen |
| Wie viel Rechner? | vier schnelle Kerne schaffen bei kurzen Notizen etwa Echtzeit | langes Material und gewöhnliche Server nicht gemessen |
| Wie gleichmäßig läuft es? | direkt hintereinander höchstens eine Sekunde Abstand, über Tage bis 14 Prozent | Wortfehlerrate nicht gemessen |
| Wer hat was gesagt? | unsichere Abschnitte werden als „unklar" markiert | Treffsicherheit der Zuordnung nicht gemessen |
| Verlässt etwas das Haus? | nein, Verarbeitung ohne Internetzugriff, Kopie wird standardmäßig gelöscht |
Quellen
- whisper.cpp, Projektseite: https://github.com/ggml-org/whisper.cpp
- whisper.cpp, Befehlsübersicht mit der Voreinstellung von vier Rechensträngen: https://github.com/ggml-org/whisper.cpp/blob/master/examples/cli/README.md
- sherpa-onnx, Projektseite: https://github.com/k2-fsa/sherpa-onnx
- sherpa-onnx, Dokumentation zur Sprechertrennung: https://k2-fsa.github.io/sherpa/onnx/speaker-diarization/index.html
- sherpa-onnx, Quellcode mit der Voreinstellung von einem Rechenstrang (
num_threads = 1): https://github.com/k2-fsa/sherpa-onnx/blob/master/sherpa-onnx/csrc/speaker-embedding-extractor.h - NVIDIA DGX Spark, Produktseite: https://www.nvidia.com/en-us/products/workstations/dgx-spark/
Alle Zeitwerte aus der eigenen Messreihe vom 09.09. bis Anfang Oktober 2026. Quellen abgerufen am 11.10.2026.